오디오 생성
캔버스에서 오디오를 만들고 사용하려면 Agent에게 오디오 생성 카드를 만들도록 요청하거나, 캔버스에 오디오 생성 노드를 직접 만들 수 있습니다.
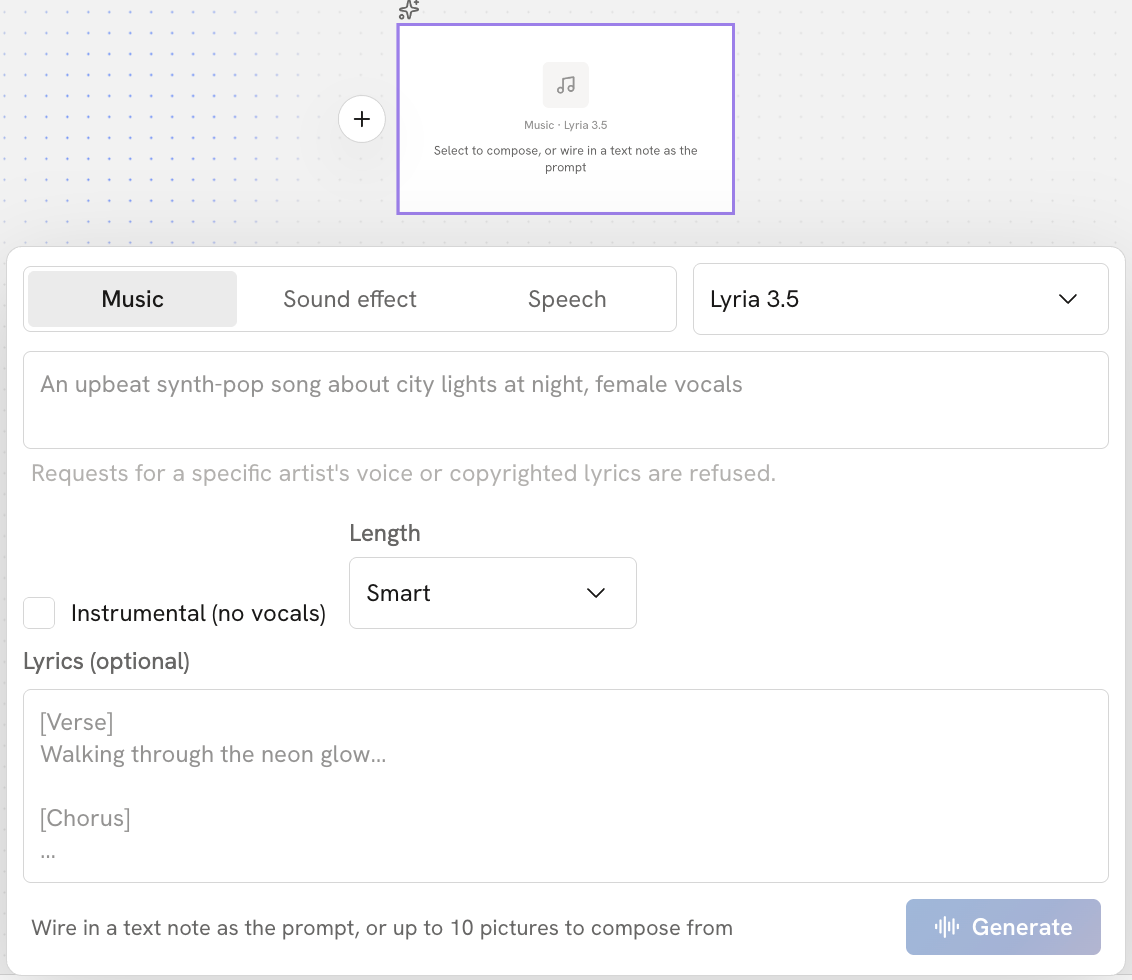
오디오 노드에서는 창작 목적에 따라 음악, 효과음, 음성 등 다양한 유형의 오디오 콘텐츠를 생성할 수 있습니다.
오디오 노드를 만든 후 노드에서 생성할 오디오 유형을 선택하고, 유형별 생성 매개변수를 조정할 수 있습니다.
음악
음악 선택 후 텍스트 설명을 통해 창작 목적에 맞는 음악을 생성할 수 있습니다.
- 모델
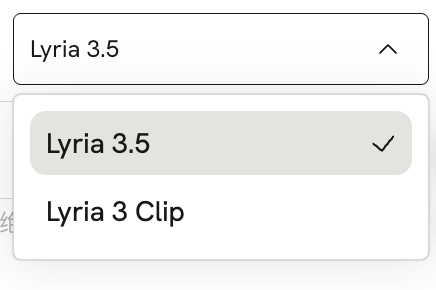
노드 오른쪽 위에서 음악 생성에 사용할 모델을 선택할 수 있습니다. 모델마다 음악 스타일, 사운드 효과, 생성 능력이 다를 수 있습니다.
- 음악 설명
생성하고 싶은 음악을 입력하세요. 음악의 장면, 분위기, 스타일, 리듬 등을 설명할 수 있습니다.
예:
어린 소녀가 바닷가에서 고래를 기다리는 장면에 어울리는 따뜻하고 마음을 치유하는 피아노 음악. 고요하고 부드러운 분위기에서 점차 밝아집니다.
- 길이
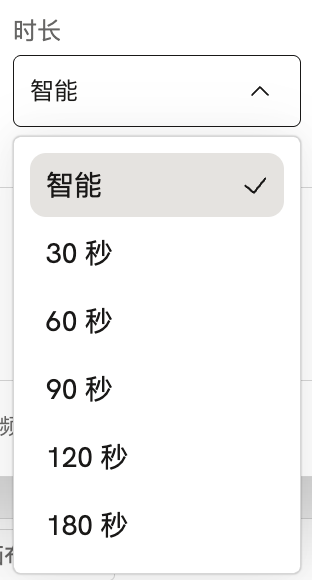
생성할 음악의 길이를 설정하거나, 스마트 선택으로 모델이 길이를 판단하도록 할 수 있습니다.
- 보컬
보컬을 포함할지 선택할 수 있으며, 필요에 따라 설명에 남성 또는 여성 보컬을 지정할 수 있습니다.
- 연주곡 (보컬 없음): 보컬 없이 음악만 생성합니다.
- 보컬 포함: 음악에 노래하는 보컬을 추가합니다.
- 가사 (선택)
노래가 포함된 음악을 생성하려면 가사 텍스트를 추가해 AI가 가사에 맞는 보컬을 생성하도록 할 수 있습니다. 가사는 선택 사항이며, 연주곡만 필요한 경우에는 가사를 추가하지 않아도 됩니다.
효과음
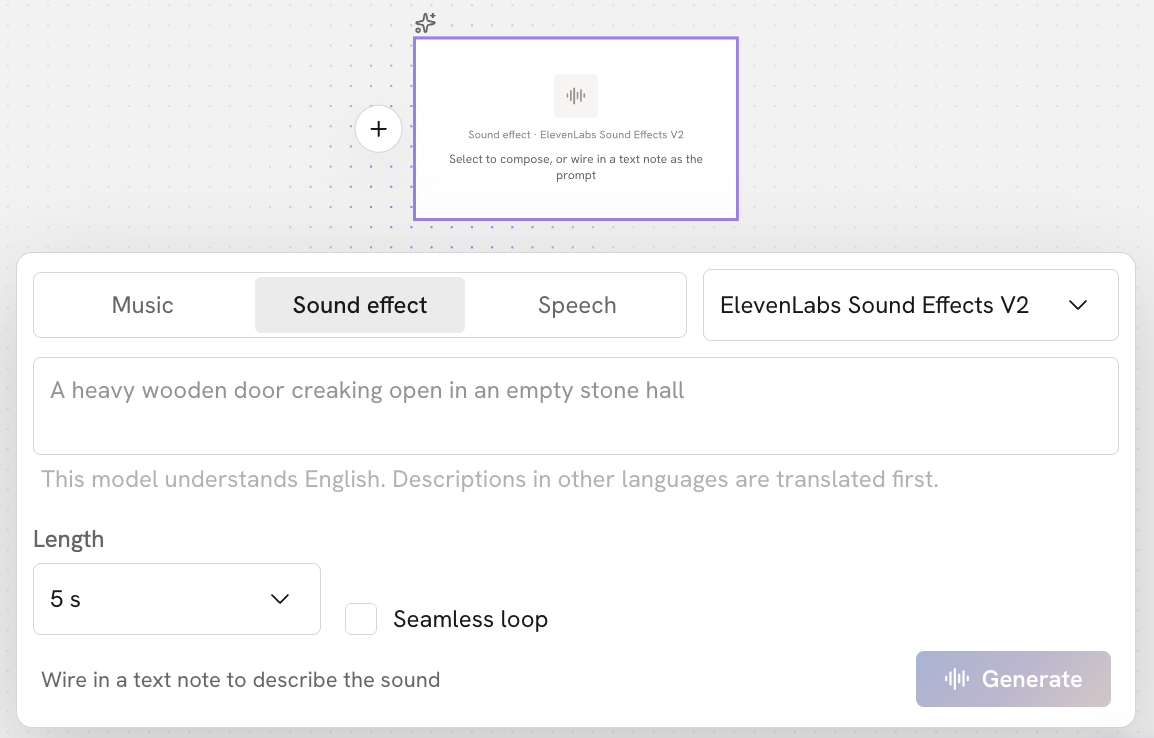
효과음 선택 후 텍스트 설명을 바탕으로 발소리, 박수 소리 등 필요한 효과음을 생성할 수 있습니다.
- 모델
노드 오른쪽 위에서 효과음 생성에 사용할 모델을 선택하세요.
- 소리 설명
생성하고 싶은 소리를 입력하세요. 소리의 출처, 동작, 환경을 최대한 명확하게 설명하세요.
예:
바닷가의 파도 소리. 파도가 나무 부두를 끊임없이 두드리며, 주변은 조용하고 사람의 말소리는 없습니다.
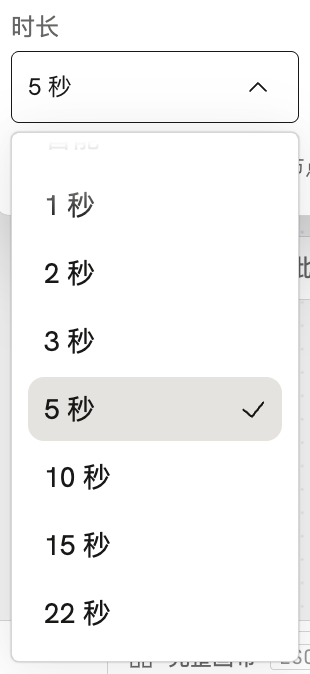
- 길이
효과음의 재생 시간을 설정하세요. 실제 사용 상황에 맞는 길이를 선택하세요.
- 끊김 없는 반복
이 기능을 켜면 생성된 효과음을 끊김 없이 반복 재생할 수 있으며, 반복되는 부분에서 눈에 띄는 끊김을 최대한 줄입니다.
다음과 같이 계속 재생해야 하는 환경음에 적합합니다.
- 파도 소리
- 빗소리
- 바람 소리
- 숲 환경음
음성
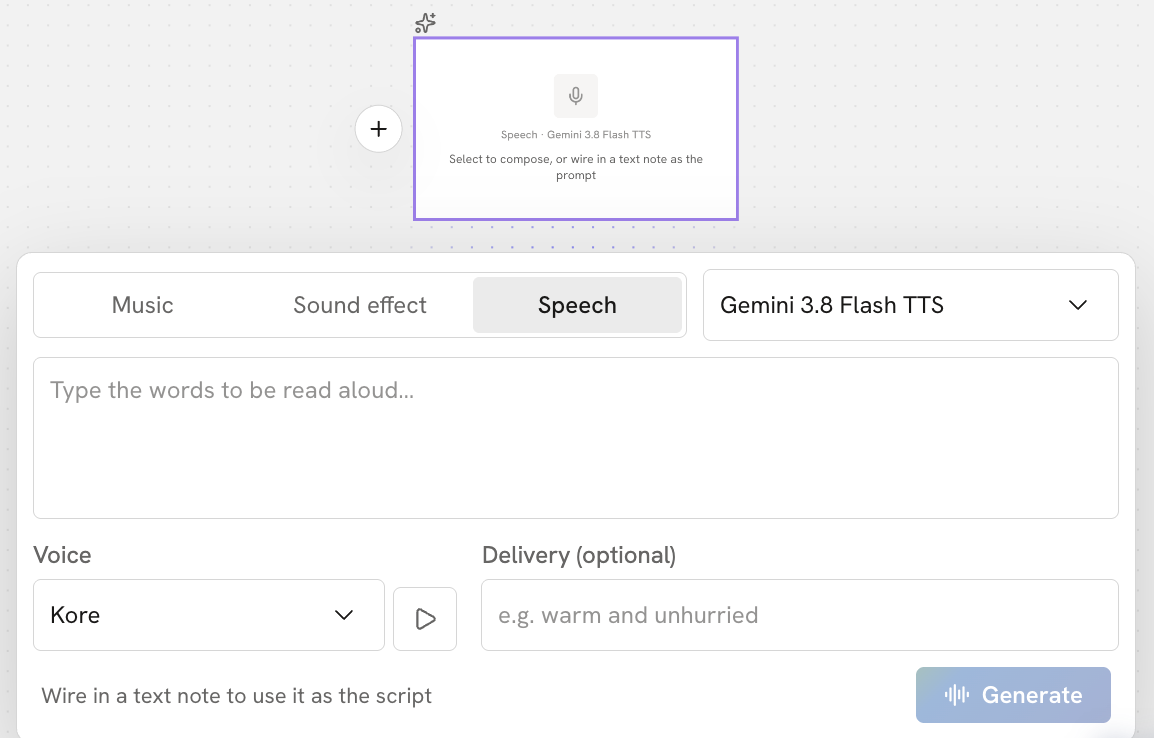
음성을 선택하면 입력한 텍스트를 자연스러운 사람의 음성으로 변환할 수 있습니다.
- 모델
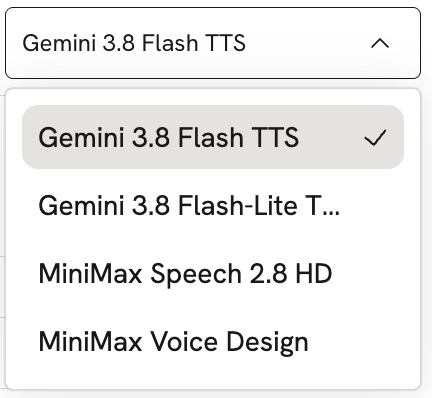
노드 오른쪽 상단에서 음성을 생성할 모델을 선택합니다.
모델에 따라 지원하는 음색, 감정, 말하기 속도 등의 기능이 다를 수 있습니다.
- 읽을 텍스트
읽을 텍스트를 입력하면 모델이 텍스트에 맞는 음성을 생성합니다.
- 목소리
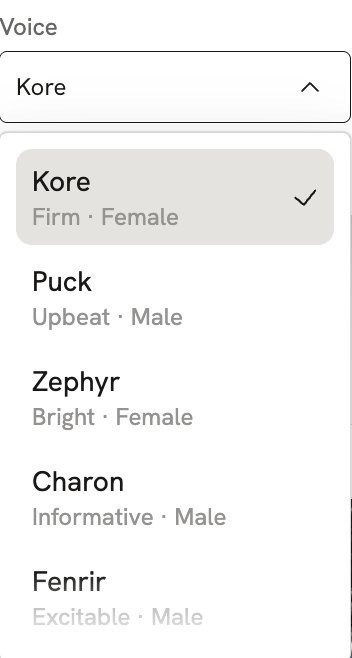
음성의 목소리 유형을 선택합니다. 캐릭터나 콘텐츠에 맞는 음색을 선택할 수 있습니다.
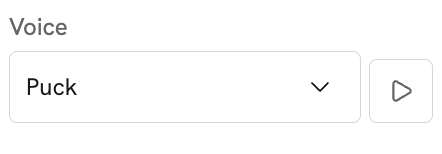
모델에 따라 제공되는 음색이 다를 수 있으며, 일부 음색은 미리 듣기를 지원합니다. 음색 옆의 재생 버튼을 클릭하면 목소리를 먼저 들어 보고 사용 여부를 결정할 수 있습니다.
- 감정
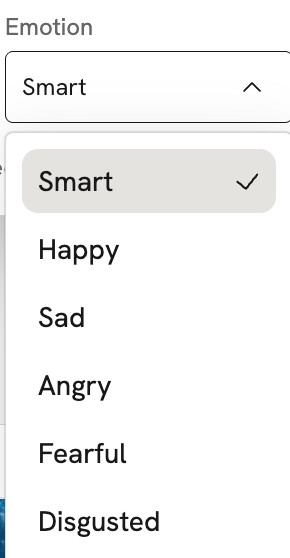
일부 모델은 감정에 따른 음성 생성을 지원합니다. 콘텐츠에 맞는 감정을 선택하면 캐릭터와 장면에 더 잘 어울리는 음성을 생성할 수 있습니다.
예를 들어 모델이 지원하는 옵션에 따라 기쁨, 슬픔, 분노 등 다양한 감정을 선택할 수 있습니다.
- 말하기 속도
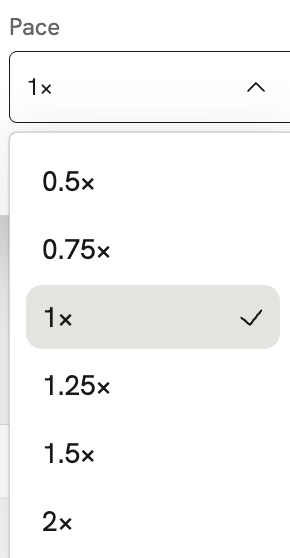
일부 모델은 말하기 속도 조절을 지원하므로 콘텐츠에 맞게 읽는 속도를 높이거나 낮출 수 있습니다.
팁 · 모델에 따라 지원하는 매개변수가 다를 수 있으며, 실제로 조절할 수 있는 옵션은 현재 선택한 모델에 따라 달라집니다.